Arquitectura Transformer
El paper que ho va canviar tot
El 2017, un equip de Google Brain va publicar el paper "Attention Is All You Need" (Vaswani et al., 2017). En ell s'introduïa l'arquitectura Transformer, que elimina la recurrència (LSTM, GRU) i la convolució, substituint-les per mecanismes d'atenció pura. El resultat: un model molt més paralel·litzable, que entrena ordres de magnitud més ràpid i captura dependències de llarg abast en el text de forma molt més efectiva.
graph TB
    subgraph ENC[Encoder x N]
        direction TB
        E_IN[Embeddings + Positional Encoding] --> E_MHA[Multi-Head Self-Attention]
        E_MHA --> E_ADD1[Add and Norm]
        E_ADD1 --> E_FFN[Feed-Forward Network]
        E_FFN --> E_ADD2[Add and Norm]
    end

    subgraph DEC[Decoder x N]
        direction TB
        D_IN[Embeddings + Positional Encoding] --> D_MHA[Masked Multi-Head Self-Attention]
        D_MHA --> D_ADD1[Add and Norm]
        D_ADD1 --> D_CROSS[Cross-Attention amb sortida de l-Encoder]
        D_CROSS --> D_ADD2[Add and Norm]
        D_ADD2 --> D_FFN[Feed-Forward Network]
        D_FFN --> D_ADD3[Add and Norm]
    end

    INPUT[Sequencia d-entrada] --> ENC
    ENC -- Keys i Values --> D_CROSS
    OUTPUT_PREV[Tokens generats fins ara] --> DEC
    DEC --> LINEAR[Linear + Softmax]
    LINEAR --> NEXTTOKEN[Probabilitat del seguent token]
Esquema complet de l'arquitectura Encoder-Decoder original de Vaswani et al. (2017). Els models només-decoder com GPT o Claude prescindeixen de la part esquerra (Encoder) i de la cross-attention.
Components principals del Transformer
Tokenització Abans de processar el text, cal convertir-lo en tokens (fragments de text, aproximadament una paraula o subparaula). El tokenitzador més usat pels LLMs moderns és BPE (Byte Pair Encoding): comença amb caràcters individuals i fusiona iterativament els parells més freqüents.
Exemple de tokenització (GPT-4 tiktoken):
"intel·ligència artificial" → ["intel", "·", "lig", "ència", " art", "ificial"]
"ChatGPT" → ["Chat", "GPT"]
"tokenitzar" → ["token", "itz", "ar"]
Embeddings de posició A diferència de les RNN, el Transformer processa tots els tokens simultàniament (en paral·lel). Per preservar l'ordre del text, s'afegeix una codificació posicional (positional encoding) a cada embedding de token. El paper original fa servir funcions sinusoïdals de freqüència decreixent:
On pos és la posició del token a la seqüència i i l'índex de la dimensió de l'embedding. Cada dimensió oscil·la a una freqüència diferent, de manera que la combinació de totes és única per a cada posició i el model pot deduir distàncies relatives entre tokens per simple àlgebra vectorial.
import numpy as np

def positional_encoding(seq_len: int, d_model: int) -> np.ndarray:
    position = np.arange(seq_len)[:, None]
    div_term = np.exp(np.arange(0, d_model, 2) * -(np.log(10000.0) / d_model))
    pe = np.zeros((seq_len, d_model))
    pe[:, 0::2] = np.sin(position * div_term)
    pe[:, 1::2] = np.cos(position * div_term)
    return pe

pe = positional_encoding(seq_len=60, d_model=64)
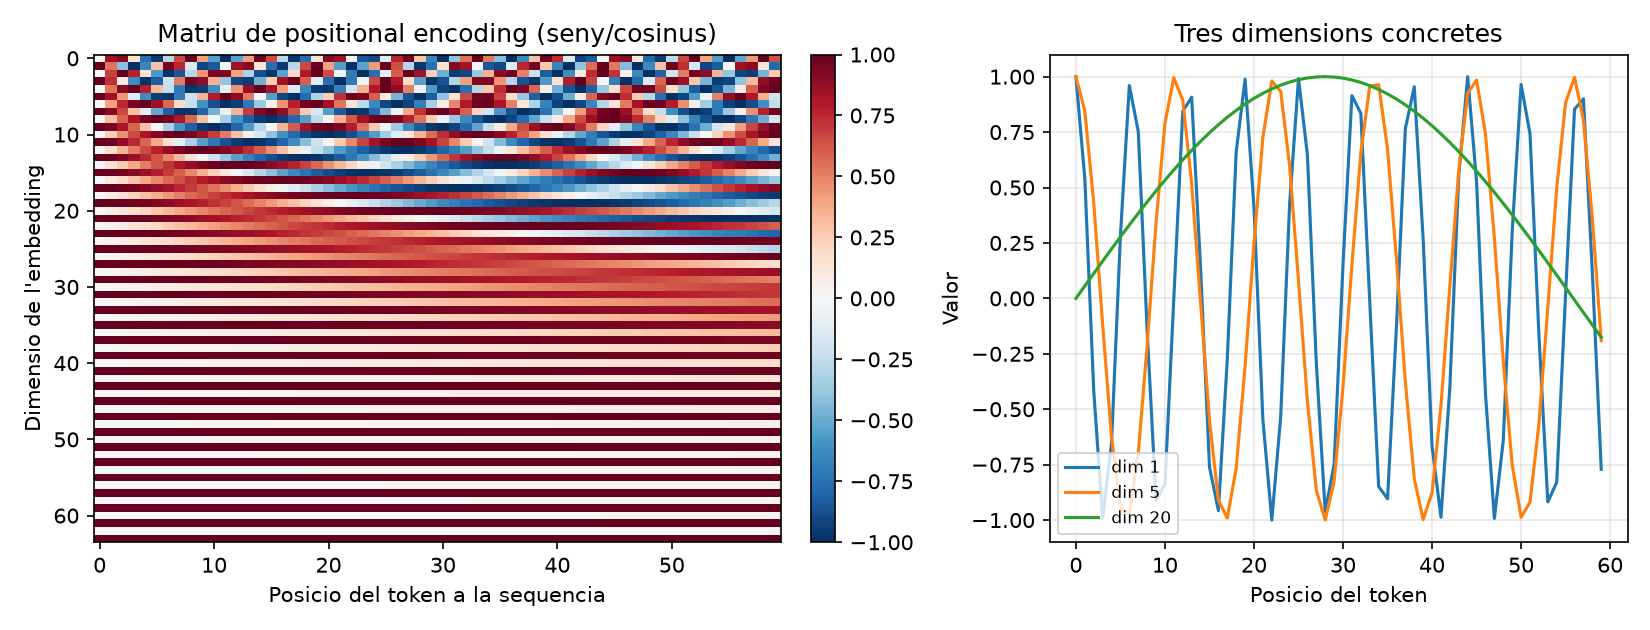
Cada fila del mapa de calor és la "empremta posicional" d'un token: les dimensions de baixa freqüència (part inferior) canvien lentament i codifiquen la posició global, mentre que les d'alta freqüència (part superior) oscil·len ràpid i codifiquen diferències fines entre posicions properes.
Multi-Head Self-Attention El mecanisme d'atenció és el cor del Transformer. Per a cada token, calcula quanta "atenció" ha de prestar a cada altre token de la seqüència.
Formalment:
Attention(Q, K, V) = softmax(QK^T / sqrt(d_k)) · V

On:
  Q = matriu de Queries (preguntes)
  K = matriu de Keys (claus)
  V = matriu de Values (valors)
  d_k = dimensió de les keys (per normalitzar)
De forma intuitiva: cada token "pregunta" quins altres tokens són rellevants per a ell (Q), els altres tokens "ofereixen" una clau identificativa (K), i es calculen les similituds. Els tokens amb similituds altes contribueixen més al seu valor de sortida (V).
El Multi-Head significa que es fan N atencions en paral·lel, cadascuna aprenent a atendre aspectes diferentes del text (sintàctic, semàntic, correferencial, etc.).
graph TD
    INPUT[Tokens d-entrada] --> EMB[Embeddings + Positional Encoding]
    EMB --> MHA[Multi-Head Self-Attention]
    MHA --> ADD1[Add and Norm]
    ADD1 --> FFN[Feed-Forward Network]
    FFN --> ADD2[Add and Norm]
    ADD2 --> NEXT[Capa seguent o sortida]

    subgraph Bloc Transformer x N
        MHA
        ADD1
        FFN
        ADD2
    end
Exemple pràctic: self-attention pas a pas amb NumPy
Per entendre la fórmula Attention(Q, K, V) = softmax(QK^T / sqrt(d_k)) · V és útil implementar-la des de zero amb una frase de joguina i mirar els números resultants:
import numpy as np

rng = np.random.default_rng(42)
tokens = ["El", "gat", "va", "menjar", "el", "peix"]
n, d_model, d_k = len(tokens), 8, 8

# Embeddings i matrius de projeccio (en un model real, s-aprenen entrenant)
X   = rng.normal(scale=0.5, size=(n, d_model))
W_q = rng.normal(scale=0.5, size=(d_model, d_k))
W_k = rng.normal(scale=0.5, size=(d_model, d_k))
W_v = rng.normal(scale=0.5, size=(d_model, d_k))

Q, K, V = X @ W_q, X @ W_k, X @ W_v

scores  = Q @ K.T / np.sqrt(d_k)                       # similituds Query-Key
weights = np.exp(scores - scores.max(axis=1, keepdims=True))
weights /= weights.sum(axis=1, keepdims=True)          # softmax fila a fila
output  = weights @ V                                  # mitjana ponderada dels Values

print(np.round(weights, 2))
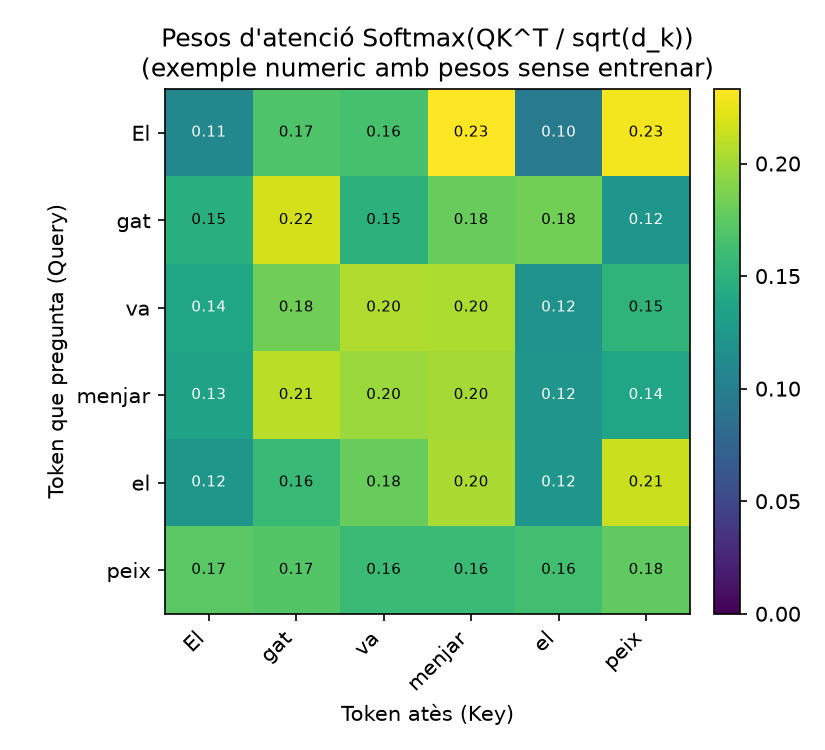
Cada fila del mapa de calor suma 1 (és una distribució softmax): indica quin percentatge d'"atenció" dedica el token de la fila (Query) a cada token de la columna (Key) a l'hora de construir la seva nova representació. En aquest exemple els pesos W_q, W_k, W_v són aleatoris (model sense entrenar), així que el patró resultant no té cap significat lingüístic — l'objectiu és purament veure la mecànica del càlcul. Durant l'entrenament, aquestes matrius s'ajusten amb backpropagation fins que l'atenció reflecteix relacions reals (p. ex. un verb atenent al seu subjecte). Per visualitzar patrons d'atenció d'un model ja entrenat es pot fer servir l'eina BertViz, que instrumenta models de Hugging Face.
Miniactivitat — AC5071/03/08
RA3 · CA3.1
Modifica el codi anterior: (1) canvia d_k a 4 i torna a executar-ho — què li passa a la forma de weights? (2) posa scores = Q @ K.T sense dividir per sqrt(d_k) i compara el rang de valors abans del softmax amb l'original. Explica en 3-4 línies per què el paper divideix per sqrt(d_k) (pista: relaciona-ho amb la saturació de la funció softmax quan els valors d'entrada són molt grans).
Feed-Forward Network Després de l'atenció, cada token passa per una xarxa neuronal densa (idèntica per a cada posició però independent). Aplica transformacions no lineals que permeten al model "processar" la informació capturada per l'atenció.
Encoder vs. Decoder
| Arquitectura | Exemples | Ús principal |
|---|---|---|
| Encoder only | BERT, RoBERTa | Classificació, NER, similitud semàntica |
| Decoder only | GPT, LLaMA, Claude | Generació de text, Q&A, chatbots |
| Encoder-Decoder | T5, BART, mT5 | Traducció, resum, generació condicionada |
Com funciona la generació de text (autoregressive decoding)
Els models de la família GPT/LLaMA/Claude funcionen com a models autoregressius: generen el text token a token, condicionant cada token als anteriors.
Prompt: "La capital de Catalunya és"

Pas 1: El model calcula la probabilitat de cada token possible com a continuació
        - "Barcelona" → 95%
        - "Girona" → 2%
        - "Madrid" → 1%
        - ... (tot el vocabulari)

Pas 2: Es selecciona "Barcelona" (amb temperature=0) o amb mostreig (temperature>0)

Pas 3: El model calcula la probabilitat de cada token possible com a continuació de
        "La capital de Catalunya és Barcelona"
        - "." → 40%
        - "," → 30%
        - " i" → 15%
        - ...

Pas 4: Es continua fins a generar un token de fi (<|endoftext|>) o arribar al límit
El pas 2 —quin token es tria a partir de la distribució de probabilitats— és el que s'anomena estratègia de descodificació (decoding strategy). No totes fan la mateixa tria, i l'elecció canvia radicalment el text resultant.
Greedy search
L'estratègia més senzilla: a cada pas, agafa el token amb la probabilitat més alta.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "mrm8488/spanish-gpt2"  # GPT-2 entrenat des de zero en castellà (~110M parametres)
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, pad_token_id=tokenizer.eos_token_id)

prompt = "El amor es eterno mientras dura. "
input_ids = tokenizer(prompt, return_tensors="pt")["input_ids"]

output_greedy = model.generate(input_ids, max_length=60, do_sample=False)
print(tokenizer.decode(output_greedy[0]))
Problema: greedy search tendeix a repetir-se en bucle (el model troba una frase "segura" i s'hi queda enganxat), perquè mai explora alternatives que semblin pitjors a curt termini però donin un resultat millor a llarg termini.
Beam search
En lloc de quedar-se només amb el millor token a cada pas, beam search manté les b seqüències parcials més probables (els "beams") i, a cada pas, expandeix totes elles amb tots els tokens possibles, quedant-se només amb les b continuacions de probabilitat conjunta més alta. Al final tria la seqüència completa amb la log-probabilitat acumulada més alta.
graph TD
    ROOT["..."] --> A["Barcelona (0.62)"]
    ROOT --> B["una (0.21)"]
    A --> A1["i (0.30)"]
    A --> A2["." "(0.55)"]
    B --> B1["ciutat (0.40)"]
    B --> B2["gran (0.18)"]

    style A2 fill:#16A34A,color:#fff
    style B1 fill:#16A34A,color:#fff
output_beam = model.generate(
input_ids, max_length=60,
num_beams=5, do_sample=False,
no_repeat_ngram_size=2, # prohibeix repetir el mateix bigrama
)
print(tokenizer.decode(output_beam[0]))
Amb num_beams=5 s'exploren 5 hipòtesis en paral·lel a cada pas. El paràmetre no_repeat_ngram_size=2 evita el mateix problema de repetició que pateix greedy search, prohibint que qualsevol seqüència de 2 tokens aparegui dues vegades.
Cost: beam search multiplica per b el nombre de passades pel model a cada pas, i tot i així no garanteix la seqüència globalment òptima (només la millor entre les b explorades). En la pràctica, els chatbots conversacionals (ChatGPT, Claude) no fan servir beam search —és massa costós i tendeix a produir text "massa a prop de la mitjana", poc natural— i opten per mètodes de mostreig.
Mostreig: temperatura, top-k i top-p
En lloc de triar sempre el token més probable, es pot mostrejar de la distribució de probabilitats. Això introdueix variabilitat i fa el text més natural i creatiu, a canvi de perdre determinisme.
Temperatura reescala els logits abans del softmax:
T → 0: equival a greedy search (determinista).T = 1: mostreig fidel a la distribució apresa pel model.T > 1: aplana la distribució — augmenta la probabilitat dels tokens rars i el text esdevé més sorprenent, però també més incoherent gramaticalment.
torch.manual_seed(42)
output_temp = model.generate(input_ids, max_length=60, do_sample=True, temperature=0.75, top_k=0)
print(tokenizer.decode(output_temp[0]))
Top-k i top-p (nucleus sampling) limiten d'on es mostreja, en lloc de reescalar tota la distribució:
- Top-k: a cada pas, només es consideren els
ktokens més probables (p. ex.top_k=50) i es mostreja només entre ells. - Top-p (o nucleus sampling): es consideren els tokens més probables fins que la seva probabilitat acumulada supera
p(p. ex.top_p=0.9). A diferència de top-k, el nombre de candidats varia dinàmicament: en un punt on el model està molt segur (una paraula domina), el conjunt és petit; en un punt ambigu, el conjunt és més gran.
torch.manual_seed(42)
output_topp = model.generate(input_ids, max_length=60, do_sample=True, top_p=0.90, top_k=0)
print(tokenizer.decode(output_topp[0]))
| Estratègia | Determinista? | Punts forts | Casos d'ús típics |
|---|---|---|---|
| Greedy search | Sí | Ràpida, reproduïble | Tasques amb resposta única (classificació, extracció) |
| Beam search | Sí | Millor coherència local que greedy | Traducció automàtica, resum (una "millor" resposta) |
| Mostreig (temperature/top-k/top-p) | No | Text variat i natural | Xat conversacional, generació creativa |
Notebook de Colab per practicar
Miniactivitat — AC5071/03/10
RA3 · CA3.1
Amb el codi anterior (o l'equivalent amb un model en català com projecte-aina/aguila-7b si tens prou recursos), genera la continuació d'un mateix prompt amb (1) greedy search, (2) beam search amb num_beams=5, i (3) mostreig amb temperature=1.2. Compara els tres resultats: quin es repeteix més? Quin sona més "creatiu" però menys coherent? Per a un chatbot d'atenció al client, quina estratègia recomanaries i per què?
Per què el Transformer escala tan bé
La raó principal per la qual és possible entrenar models amb centenars de milers de milions de paràmetres és la paral·lelització: com que tots els tokens es processen alhora (i no un a un com a les RNN), l'entrenament es pot repartir massivament entre milers de GPU/TPU.
| Aspecte | RNN / LSTM | Transformer |
|---|---|---|
| Processament dels tokens | Seqüencial (un rere l'altre) | Paral·lel (tots alhora) |
| Complexitat per capa | O(n · d²) | O(n² · d) |
| Camí més llarg entre dos tokens | O(n) passos | O(1) — atenció directa |
| Aprofitament de GPU | Baix (dependència seqüencial) | Molt alt |
El cost quadràtic de l'atenció
El terme O(n²) de la taula és el preu a pagar: doblar la longitud de la seqüència (n) quadruplica el cost de calcular QK^T. És per això que la mida de la finestra de context (vegeu Limitacions del PLN) ha estat durant anys un dels principals colls d'ampolla dels LLMs, i per què han aparegut variants més eficients (atenció dispersa, FlashAttention, atenció lineal) per allargar el context sense disparar el cost computacional.